Serwer MCP dla Claude Desktop nad wynikami badań krwi
- Claude Code
- AI
- MCP
- Prywatność
Trzy lata wyników badań krwi mam rozrzucone w segregatorze z papierowymi wydrukami z laboratorium i w folderze ze skanami i zdjęciami na dysku — bez jednego miejsca, które cokolwiek podsumowywało. Pytanie „jak zmieniała się moja ferrytyna od ostatniego roku” oznaczało przekopanie całego zbioru dokumentów: znalezienie właściwych badań, wyłowienie konkretnych dat, ręczne przepisanie liczb z PDF-ów — za każdym razem od nowa, żeby cokolwiek porównać w czasie. Żmudne i podatne na pomyłkę. Zbudowałem więc lokalny pipeline, który to automatyzuje — a potem, w ramach nauki agentic codingu, poszedłem krok dalej: otworzyłem te dane przez serwer MCP dla Claude Desktop, żeby pytać o trend czy porównanie wprost w Claude Desktop, bez dotykania terminala.
To nie jest tekst o medycynie. To case study z realnego PRD, dwóch ADR-ów (Architecture Decision Record — krótki dokument spisujący jedną decyzję architektoniczną: kontekst, wybór, uzasadnienie) i garści notatek z wdrożenia — dokładnie tych materiałów, które sam chciałbym przeczytać, zanim zacząłem.
Punkt wyjścia: mechanizm działał, dostępu nie było
Wersja pierwsza projektu (OCR na Docling z Apple Vision, standaryzacja nazw markerów przez YAML i regexy, zaufany magazyn NDJSON) już umiała liczyć trend i porównanie dwóch markerów — ale wyłącznie z poziomu Claude Code w terminalu, bo to jedyny klient, który miał wbudowany dostęp do systemu plików bez żadnej dodatkowej konfiguracji. Claude Desktop w standardowej rozmowie tego dostępu nie ma — da się go dopiąć osobnym connectorem, tak jak w moim innym workflow, gdzie na starcie sesji montuję folder projektu. Ale nawet z takim connectorem Desktop dostałby tylko surowe bajty pliku NDJSON, nie logikę domenową: rozpoznawanie aliasów markera, grupowanie po jednostce, filtrowanie po kodzie. Musiałby tę logikę odtwarzać sam, przy każdym pytaniu, bez gwarancji spójności z tym, co już przetestowane w report.py. Problemem nie był więc goły dostęp do bajtów — to był brak dostępu do tej samej, sprawdzonej logiki, którą miał już Claude Code. Dokładnie to rozwiązuje protokół MCP: daje klientowi bez tej logiki ustandaryzowany sposób wywołania narzędzia, które ją ma.
Serwer MCP dla Claude Desktop — dlaczego stdio, nie serwer sieciowy
Pierwsza decyzja, którą trzeba było podjąć świadomie, nie „bo tak się zwykle robi”: transport. Diagram architektury sugerował serwer nasłuchujący na porcie, do którego łączy się wielu klientów. Wybrałem inaczej — stdio: serwer uruchamiany jako subproces bezpośrednio przez klienta, na podstawie jego własnej, ręcznie edytowanej konfiguracji.
Różnica nie jest kosmetyczna. Serwer na porcie bez autoryzacji odpytałby każdy, kto do tego portu sięgnie — inne konto na Macu, strona otwarta w przeglądarce, a przy złej konfiguracji urządzenie w tej samej sieci. Stdio nie nasłuchuje nigdzie: serwer żyje tylko jako podproces klienta, który sam go uruchomił. Granica przesuwa się z „co wysyłam do API” na „który klient ma serwer w configu” — dane trafiają do modelu wyłącznie wtedy, gdy sam dopiszę serwer do konfiguracji konkretnego klienta. Uczciwie trzeba dodać, czego stdio nie zmienia: proces działający na moim koncie przeczyta plik NDJSON wprost, z serwerem czy bez. Granicą bezpieczeństwa danych na dysku zostaje konto użytkownika — stdio nie dokłada do niej nowej furtki.
To ta sama klasa ryzyka, co przy pierwszej wersji projektu, gdzie do żadnego API nie szły wartości pomiarów, tylko nazwa markera. W wersji drugiej realne wyniki (wartości, daty, zakresy referencyjne) trafiają już do kontekstu modelu klienta MCP — bo to jest właśnie wartość produktowa, trend i porównanie czytelne dla modelu. Świadomie rozszerzony zakres, nie przeoczenie — i dokładnie dlatego cała mitygacja prywatności nie polega na filtrowaniu treści, tylko na tym, kto może w ogóle nawiązać połączenie.
Jedno uściślenie, żeby nie przeciągnąć struny: same rekordy, które trafiają do modelu, nie niosą żadnego identyfikatora pacjenta — nazwiska, PESEL-u, numeru karty. Tylko kod markera, data badania, wartość, zakres referencyjny. Co dany klient MCP robi dalej z tymi danymi w swoim kontekście — czy je przechowuje, czy wiąże z moim kontem — zostaje poza kontrolą tego serwera, tak samo jak zaufanie do Claude Code było już przyjęte w wersji pierwszej. To świadomie nazwana granica projektu, nie luka, o której zapomniałem.
Wyłącznie odczyt — granica, nie przypadek
Druga decyzja: serwer wystawia tylko narzędzia do odczytu. Rozważyłem i odrzuciłem wariant z zapisem — np. zatwierdzanie propozycji nowego aliasu markera wprost z Claude Desktop, zamiast ręcznej edycji pliku w Claude Code.
Powód jest prosty: mechanika zatwierdzania aliasów — plikowa, z człowiekiem w pętli — działa i jest sprawdzona od pierwszej wersji. Duplikowanie jej w nowym kanale nie miało uzasadnienia, za to zwiększało powierzchnię ryzyka: klient MCP mógłby zmieniać zaufany słownik domenowy, na co żadna realna potrzeba nie wskazywała. Luka, którą naprawdę trzeba było zamknąć, to brak odczytu z klientów bez dostępu do plików — nie brak alternatywnej ścieżki zapisu. Dopisanie „skoro już tam jesteśmy, dorzućmy zapis” byłoby dokładnie tym scope creepem, który brzmi rozsądnie w danym momencie i wychodzi bokiem przy pierwszym audycie.
Rozpoznawanie markera: kod, etykieta, czy skrót przed nawiasem
Najciekawszy kawałek logiki nie jest wcale skomplikowany, ale ma pułapkę, której bym się nie spodziewał. Model wywołujący narzędzie może podać identyfikator markera na trzy sposoby: kod kanoniczny (HGB), pełną polską etykietę („Hemoglobina”) albo skrót sprzed nawiasu w etykiecie — bo słownik markerów trzyma niektóre nazwy jako „OB (odczyn Biernackiego)”, a naturalne jest zapytać po prostu o „OB”.
def resolve_marker(
    identifier: str, labels: dict[str, str] | None = None
) -> str:
    query_lower = (identifier or "").strip().lower()
    code_by_lower = {code.lower(): code for code in labels}
    label_by_lower = {
        label.strip().lower(): code
        for code, label in labels.items()
    }
    prefix_by_lower = _prefix_aliases(labels, code_by_lower)

    if query_lower in code_by_lower:
        return code_by_lower[query_lower]
    if query_lower in label_by_lower:
        return label_by_lower[query_lower]
    if query_lower in prefix_by_lower:
        return prefix_by_lower[query_lower]

    candidates = {
        **code_by_lower, **label_by_lower, **prefix_by_lower
    }
    close = get_close_matches(
        query_lower, candidates.keys(), n=3, cutoff=0.6
    )
    suggestions = sorted({candidates[c] for c in close})
    raise MarkerNotFound(identifier, suggestions)
Skrót przed nawiasem trzeba było dopisać jako osobną warstwę, bo dopasowanie rozmyte porównuje długości całych ciągów — „OB” i „OB (odczyn Biernackiego)” są zbyt różnej długości, żeby połączyć się same z siebie. Ale sam prefiks jest niebezpieczny bez dodatkowego sprawdzenia: „PTH (1-84)” dałoby prefiks „pth”, który już jest kodem zupełnie innego markera. Prefiks wchodzi więc do słownika tylko wtedy, gdy nie koliduje z żadnym istniejącym kodem — przy kolizji narzędzie milczy o tym aliasie zamiast zgadywać, o który marker chodziło. Zero dopasowania jest tu bezpieczniejsze niż złe dopasowanie.
Ta sama zasada rządzi całym kontraktem: nierozpoznany identyfikator nigdy nie zwraca cichej pustej listy — zawsze jawny status „nie znaleziono” z podpowiedzią najbliższych dopasowań. Literówka i „marker istnieje, zero pomiarów” muszą wyglądać inaczej, bo model po drugiej stronie inaczej je zinterpretuje.
Pułapka: Desktop nie widział nowych narzędzi
Rejestracja serwera w Claude Desktop poszła gładko przy pierwszym, trywialnym narzędziu (ping → "pong") — komenda instalacyjna sama dopisała wpis do configu, razem z pełną ścieżką do binarki uv. Awaria wyszła dopiero, gdy narzędzia zaczęły importować zależność YAML z modułu domenowego.
Powód: komenda instalacyjna nie ma opcji na katalog roboczy — sprawdzone wprost w źródle biblioteki, nie zgadywane. Desktop odpala podproces z jakiegoś swojego katalogu, nie z katalogu projektu, więc uruchomienie bez wskazanego katalogu nie znajdowało plików projektu i zamiast jawnego błędu cicho lądowało na innej instalacji z PATH (u mnie: pod pyenv, bez potrzebnej zależności). Diagnoza była myląca, bo ręczne odtworzenie tej samej komendy z terminala, z katalogu projektu, działało bez zarzutu — dopiero uruchomienie z katalogu domowego odtworzyło błąd jeden do jednego. Naprawa to jedna linia dopisana ręcznie do configu, flaga katalogu roboczego zaraz po komendzie uruchamiającej. Automat jej nie doda nigdy — trzeba pamiętać o tym przy każdej reinstalacji.
Pułapka: fraza z PRD nie zadziałała
Kryteria sukcesu miały konkretne przykładowe zapytania — „porównaj hemoglobinę i OB” dla drugiego narzędzia. Wpisane dosłownie w Claude Desktop, nie zadziałało: model potraktował to jako pytanie edukacyjne o różnicę między markerami i odpowiedział ogólną wiedzą medyczną, nie sięgając po narzędzie w ogóle — mimo że działało poprawnie, potwierdzone niezależnie przez MCP Inspector chwilę wcześniej.
To nie był błąd kodu. Dopiero fraza „porównaj moje wyniki hemoglobiny i OB w czasie” zadziałała — bo jawnie sygnalizowała dane osobiste i oś czasu, dwa sygnały, których model potrzebował, żeby odróżnić „zapytaj mnie o wiedzę” od „sięgnij po narzędzie”. Kontrakt narzędzia (niezależne serie, bez łączenia po dacie) zostawał bez zmian — to model, już po stronie odpowiedzi, składał dwie serie w jedną czytelną tabelę. Poniżej realna odpowiedź z tego zapytania — bez żadnej ingerencji z mojej strony poza samym pytaniem:
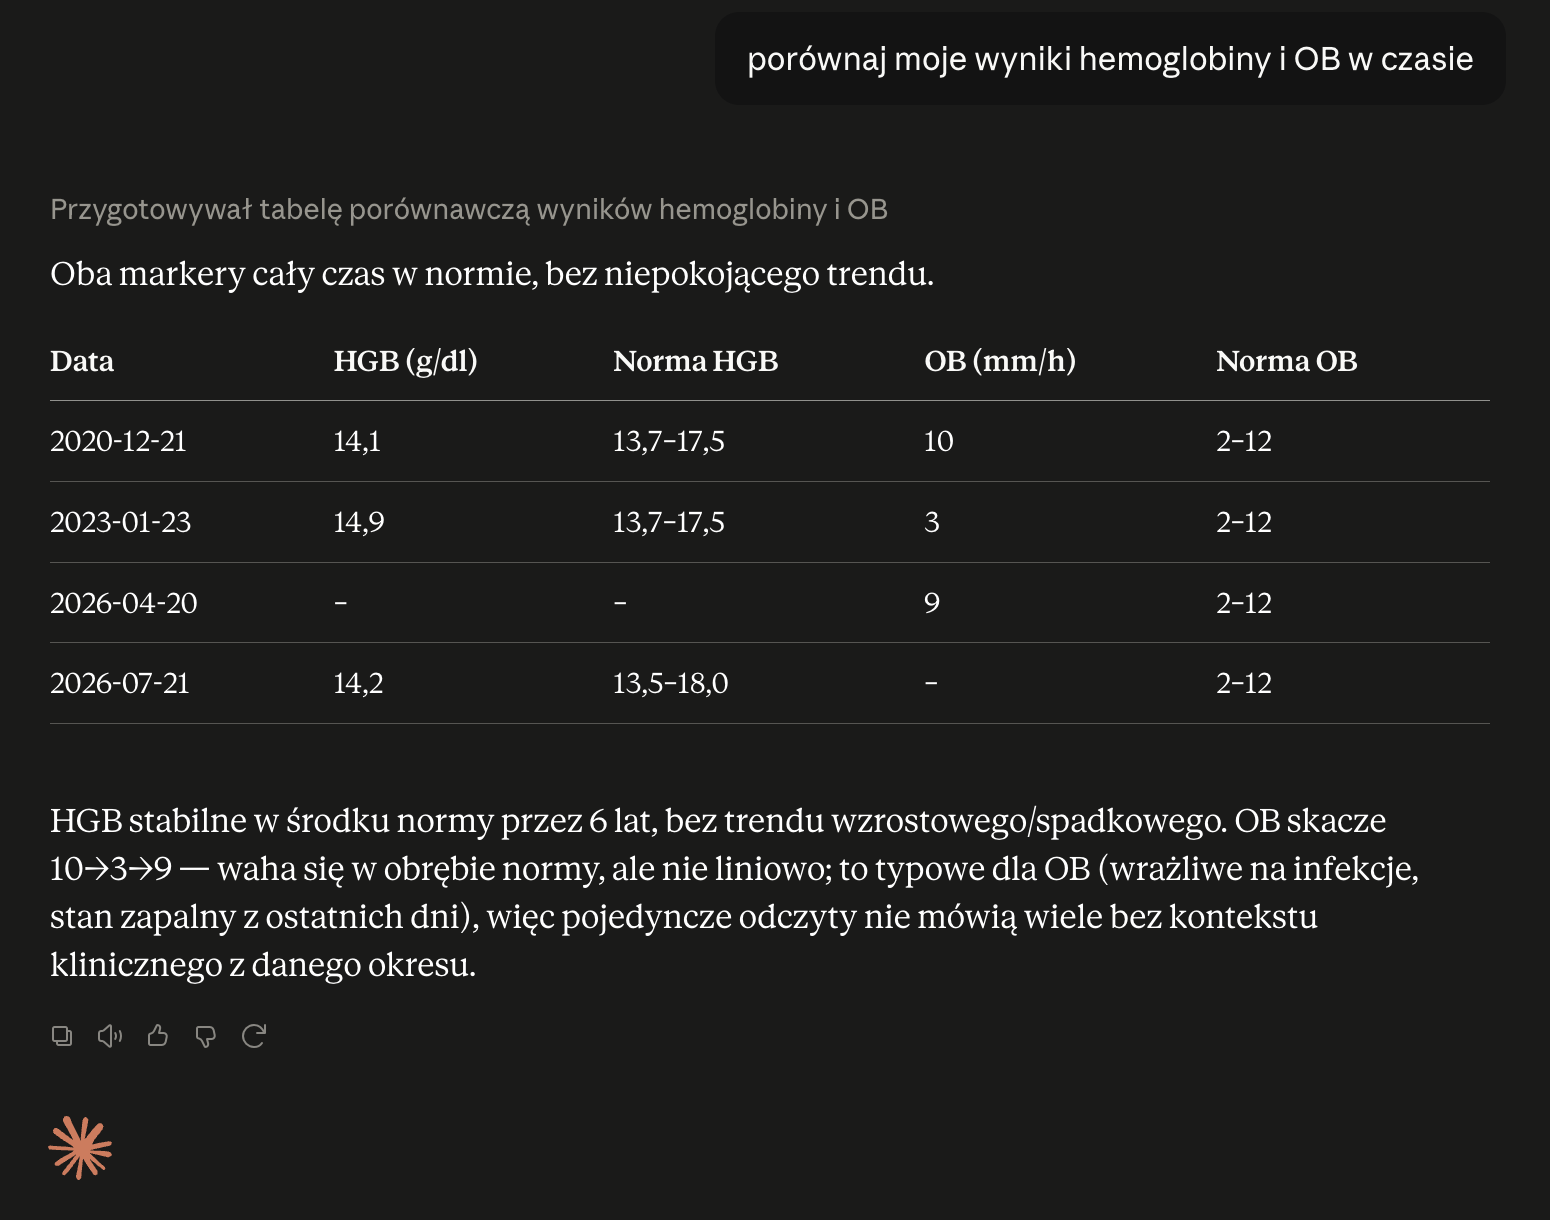
Wartości mieszczą się w normie przez cały okres, dlatego pokazuję je bez zaciemniania — to zresztą lepiej ilustruje sedno niż fikcyjny przykład: dwie w pełni niezależne serie o różnych datach badań (HGB i OB bada się zwykle innego dnia), świadomie bez łączenia po dacie — a mimo to model po stronie odpowiedzi złożył je w jedną czytelną tabelę i dopisał interpretację kliniczną, o którą nie prosiłem wprost w treści zapytania. Wniosek, który zabieram do każdego kolejnego promptu łączącego wywołanie narzędzia z pytaniem w naturalnym języku: przykład z dokumentacji może nie triggerować narzędzia tak, jak zakładasz, dopóki go realnie nie sprawdzisz z docelowym klientem.
„Mechanizm działa” to nie „kryterium spełnione”
Cała weryfikacja szła w trzech warstwach rosnącego kosztu: testy jednostkowe czystej logiki (rozpoznawanie markera, grupowanie po jednostce, błąd dla nieznanego identyfikatora) → ręczne wywołanie przez MCP Inspector, bez konfigurowania Desktopa → dopiero na końcu realne zapytanie z samego Desktopa, jak wyżej. Żadna z pierwszych dwóch warstw nie liczyła się jako dowód gotowości — bo wersja pierwsza projektu już raz pokazała, że zielona odpowiedź na wywołanie techniczne i spełnione kryterium produktowe to dwa różne stwierdzenia.
Co z tego wynika
Dla mnie ten projekt to nie „nauczyłem się MCP” — to ten sam agentic coding workflow, który opisuję na tej stronie przy innych projektach, przeniesiony z kodu produkcyjnego na dane medyczne: co idzie do kontekstu modelu, kto może się połączyć, gdzie kończy się automat, a zaczyna człowiek w pętli. Ta sama dyscyplina, którą opisałem przy self-review loop i hookach Claude Code — tam deterministyczny hook nie pozwala agentowi skończyć bez spełnionych kryteriów, tutaj trzy warstwy weryfikacji nie pozwalają uznać serwera za gotowy bez realnego dowodu z docelowego klienta. Ten sam wzorzec widać też przy własnej bazie wiedzy w Obsidianie — inny projekt, ta sama zasada: nie ufaj mechanizmowi, dopóki nie zadziałał end-to-end z realnym klientem, nie tylko w izolacji.
Transport sieciowy i rewizja modelu zagrożeń to świadomie odłożone pytanie na kolejną wersję, jeśli projekt kiedyś przeniesie się do chmury. Na teraz stdio i wyłączny odczyt zostają — bo to one dokładnie odpowiadają na pytanie, które miałem przed rozpoczęciem: jak otworzyć dane na nowego klienta, nie zmieniając przy tym, kto ma nad nimi kontrolę.
Dostęp to jednak nie koniec historii — samo pytanie „jak zmieniała się ferrytyna” wciąż wymagało, żebym ja sam wiedział, o co pytać. Część 2 tej serii opisuje, jak nad tym samym serwerem zbudowałem agenta na Claude Agent SDK, który sam planuje, które narzędzie wywołać: Claude Agent SDK nad własnym serwerem MCP.
Ten sam schemat decyzji przenosi się wprost do pracy z klientami e-commerce, tylko magazyn danych jest inny. Serwer MCP nad hurtownią BigQuery/dbt zamiast nad NDJSON, ale te same trzy pytania: kto się łączy (stdio czy opt-in per klient, nie otwarty port do sieci firmowej), czy w ogóle wolno pisać (przy analityce zwykle nie — dashboard nie powinien mieć prawa nadpisać modelu dbt) i czy narzędzie oddaje surowy dostęp do tabel, czy warstwę rozpoznawania identyfikatorów (żeby stakeholder pytający o „przychód” dostał ten sam kanoniczny event co analityk, nie zgadywankę po nazwach kolumn). To nie hipoteza — pierwszy krok tej samej drogi opisałem już w Google MCP Toolbox i Data Agent Kit, inny magazyn, ten sam wzorzec.