Asystent głosowy w n8n — pętla mów-słuchaj bez linijki backendu
Nagrywasz pytanie mikrofonem w przeglądarce. Kilka sekund ciszy. W odpowiedzi słyszysz głos — nie czytasz dymka w czacie, słyszysz zdanie wypowiedziane przez syntezator mowy. Cały interfejs to mikrofon i głośnik, zero okna czatu. Taki asystent głosowy w n8n składa się z pięciu węzłów w głównym łańcuchu i jednego podpiętego modelu — bez pisania własnego backendu do obsługi audio.
Asystent głosowy w n8n — pięć kroków pętli
Workflow w edytorze n8n nazywa się „Czat z syntezą mowy” — nazwa myląca, została z wcześniejszej wersji, w której faktycznie stał tam panel czatu. Dziś czatu nie ma, tylko webhook i mikrofon w przeglądarce. Cały mechanizm stoi na integracji n8n z ElevenLabs przez jeden community node (@elevenlabs/n8n-nodes-elevenlabs), doinstalowany z panelu n8n, nie wbudowany klocek. To, co realnie się dzieje:
- Webhook (
POST) przyjmuje nagranie audio jakomultipart/form-data— wysyła je strona testowavoice.html, która nagrywa głos wprost z mikrofonu przeglądarki przezMediaRecorder. Kod tu jest, tylko leży w przeglądarce, nie na serwerze. - ElevenLabs (
speech.speechToText) transkrybuje nagranie na tekst, z wymuszonym rozpoznawaniem języka polskiego. Pole modelu zostawiłem puste — n8n używa wtedy domyślnego modelu ElevenLabs dla tej operacji, czylieleven_scribe_v1(Scribe v1). - AI Agent — model
openai/gpt-oss-120bprzez OpenRouter (w wariancie:freebez opłat), jedyny działający na moim koncie — czyta transkrypcję jako pytanie i generuje odpowiedź tekstową po polsku (system prompt wymusza język). Bez pamięci, bez narzędzi: każda odpowiedź jest jednorazowa, niezależna od poprzednich. n8n nazywa to „agentem” z racji typu node’a — architektonicznie to gołe wywołanie modelu, nie pętla z narzędziami. - Drugi raz ten sam node ElevenLabs, tym razem
textToSpeech, modeleleven_multilingual_v2, głos „Sarah” — zamienia odpowiedź z powrotem na plik audio. - Respond to Webhook odsyła ten plik jako właściwą odpowiedź HTTP na oryginalne żądanie.
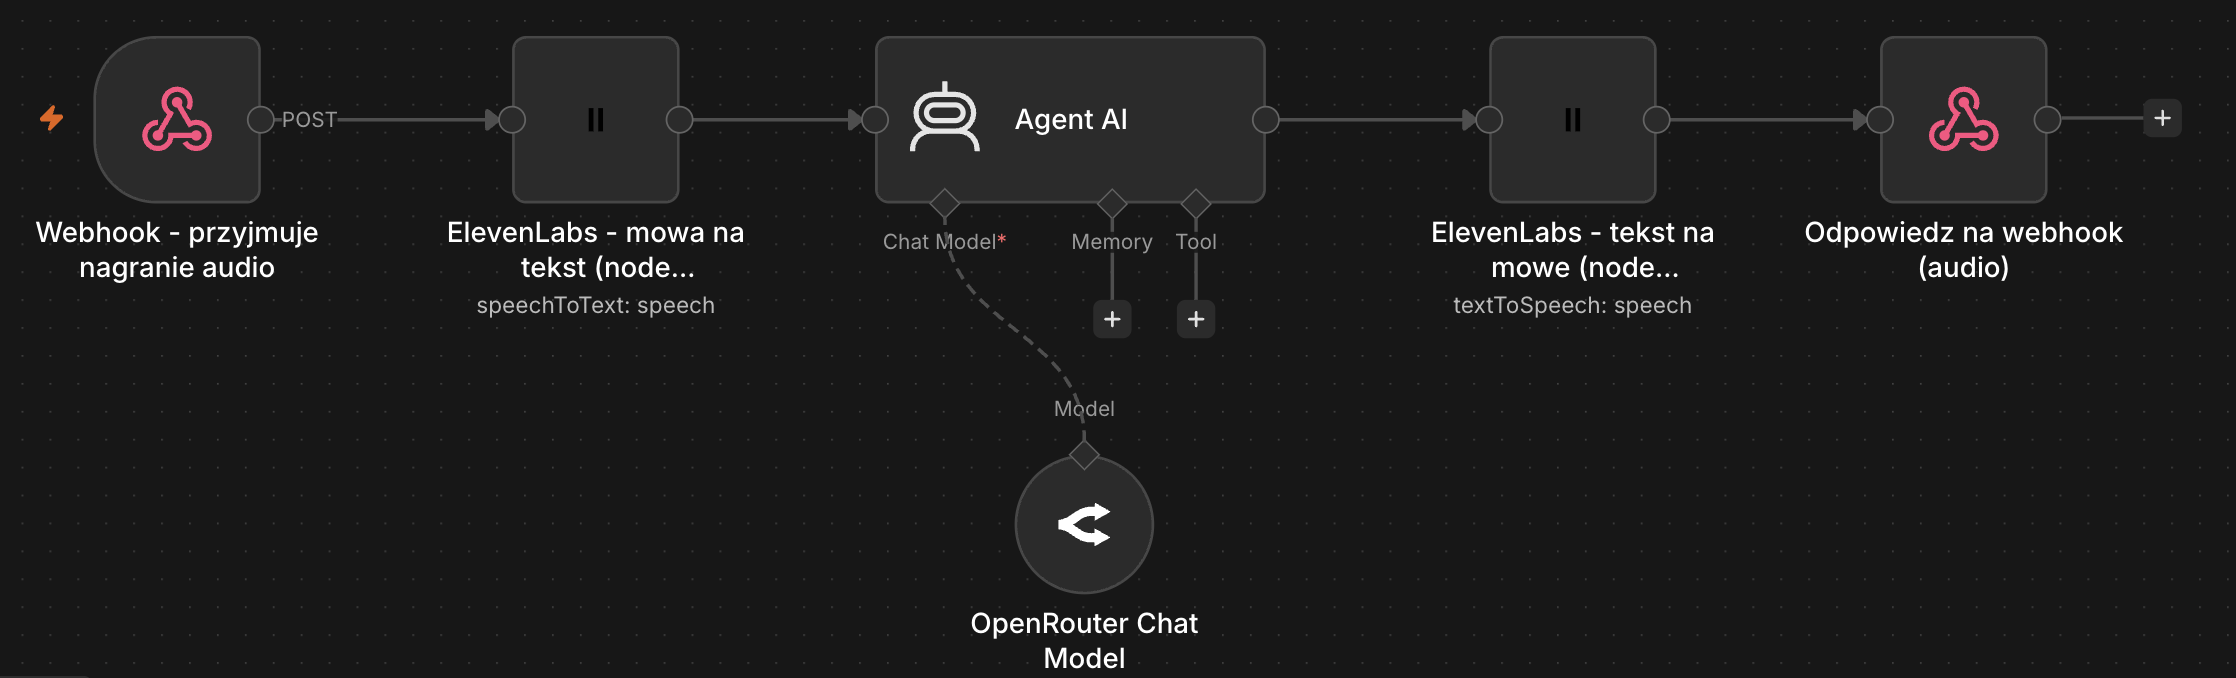
Webhook, który czeka, zamiast odpowiadać od razu
Webhook w n8n ma trzy tryby odpowiedzi. Domyślny, Immediately, odpowiada od razu po przyjęciu żądania komunikatem Workflow got started — nie czeka na wynik. Drugi, When Last Node Finishes, czeka na koniec łańcucha i z opcją Response Data: First Entry Binary odeśle nawet plik — ale nagłówki i kształt odpowiedzi zostawia domyślne. Wybrałem trzeci tryb: responseMode: responseNode na webhooku plus osobny węzeł Respond to Webhook na samym końcu łańcucha, z ustawieniem Respond With: Binary File. On jawnie decyduje, kiedy i co wraca do klienta, z jakim content-type i nagłówkami — przy audio odtwarzanym w przeglądarce to mniej zgadywania.
Ile to trwa? Przetwarzanie po stronie n8n — transkrypcja, LLM, synteza — zajmuje około 4 sekund (zmierzone: 3,85 s w jednym z uruchomień, z historii egzekucji). To nie jest pełny czas między naciśnięciem mikrofonu a usłyszeniem odpowiedzi — dochodzi jeszcze nagranie, transfer przez tunel ngrok i odtworzenie audio po stronie przeglądarki, których osobno nie mierzyłem. W praktyce czekasz kilka sekund dłużej niż te 4 s z logów n8n.
Ten sam problem — coś asynchronicznego i wielokrokowego schowane za jednym wywołaniem — rozkładałem inaczej przy audycie szablonu n8n: tam zamiast czekać na jeden długi łańcuch, workflow odpytuje status w pętli. Dwa różne wzorce na ten sam rodzaj kłopotu — wybór zależy od tego, czy druga strona ma cierpliwość trzymać połączenie otwarte (tu: przeglądarka czeka na dźwięk), czy lepiej odpowiedzieć od razu i pollingować później.
Pułapka, której nie znajdziesz w dokumentacji
Nagranie z przeglądarki trafia do n8n jako pole binarne o nazwie data0, nie data. n8n przy multipart/form-data dokleja numer do nazwy pola z konfiguracji webhooka — więc jeśli w dalszych węzłach odwołujesz się do binary.data, dostajesz cichy błąd albo pusty plik, bez podpowiedzi, gdzie szukać przyczyny. Obejście: zostaw pole „Field Name for Binary Data” w konfiguracji webhooka puste — wtedy n8n zachowuje oryginalne nazwy pól z formularza, zamiast doklejać numerację. Znalazłem to metodą prób i błędów przy pierwszym realnym teście, nie w opisie node’a.
Czym to jest, a czym nie
To działający prototyp na własnym komputerze — n8n w Dockerze, webhook wystawiony na zewnątrz tylko na czas testu przez tunel ngrok. Nie jest to stały, publicznie dostępny serwis, i nie udaję, że jest — to demo z nauki, odtwarzalne lokalnie przez każdego, kto poskłada ten sam zestaw węzłów. Chcę pokazać to komuś zdalnie — odpalam tunel na czas demo i zamykam go zaraz potem.
Droga na produkcję nie wymaga przebudowy architektury: zamiast ngroka n8n staje na VPS z własnym HTTPS i uwierzytelnianiem webhooka, reszta łańcucha — STT, agent, TTS, odpowiedź — zostaje bez zmian. Brakuje tu nie architektury, tylko stałego miejsca w sieci.
Gdzie to ma sens biznesowo
Sam webhook głosowy nikomu nic nie sprzeda — ale pętla pod spodem rozwiązuje problemy, które nie mają nic wspólnego z zabawą głosem:
- Notatki handlowca prosto do CRM. Po spotkaniu handlowiec nagrywa 30 sekund podsumowania w aucie, zamiast wpisywać je wieczorem z pamięci. Ten sam łańcuch STT → agent → zapis zamienia nagranie na ustrukturyzowaną notatkę w polach CRM.
- Pierwszy kontakt w infolinii. Zamiast sztywnego drzewka „naciśnij 1, naciśnij 2”, dzwoniący mówi, o co chodzi, a agent kwalifikuje sprawę i kieruje ją dalej — do działu, do FAQ, albo do człowieka, jeśli sprawa jest złożona.
- Zapytanie o dane bez otwierania laptopa. Głosowy wariant bota Slack z GA4 — pytanie zadane w aucie albo w magazynie, odpowiedź usłyszana, nie przeczytana.
Różnicę robi to, co stoi w miejscu gołego wywołania modelu z tego demo: agent z pamięcią, narzędziami i dostępem do realnych danych, nie jednorazowy odpowiadacz.
Wnioski
- Dedykowany node speech-to-text/text-to-speech zdejmuje cały ciężar obsługi audio. Nie piszesz kodu do dekodowania plików, buforowania streamu ani wyboru formatu — ElevenLabs robi to za jednym wywołaniem po obu stronach pętli.
- n8n nazywa to „agentem”, ale bez pamięci i narzędzi to gołe wywołanie modelu — nazwa bierze się z typu node’a, nie z architektury. Do rozmowy z dopytaniami trzeba dołożyć pamięć i narzędzia, jak w scenariuszach wyżej.
- Webhook z opóźnioną odpowiedzią to wzorzec ogólny, nie trik pod audio — wraca wszędzie tam, gdzie jedno żądanie kryje za sobą wielokrokowy, sekwencyjny łańcuch.
- Koszt realnie leży w warstwie speech, nie w modelu. Transkrypcja (Scribe, ok. $0,22 za godzinę nagrania) to ułamek grosza na jedno pytanie; synteza krótkiej odpowiedzi (Multilingual v2, $0,10 za 1000 znaków) to już pojedyncze grosze. Model tekstowy (
openai/gpt-oss-120bprzez OpenRouter) w wariancie:freenie kosztuje nic, a w płatnym — ułamki centa na pytanie, bo tu nie ma pętli narzędziowej ani rosnącej pamięci, która napędzałaby zużycie tokenów.
Ceny ElevenLabs, stan na wrzesień 2026. Cenniki API bywają korygowane — zweryfikuj aktualne stawki przed wdrożeniem.
Cały mechanizm — pięć węzłów w łańcuchu plus jeden podpięty model, zero customowego backendu do obsługi dźwięku — pokazuje, ile dziś da się złożyć z gotowych klocków, zanim w ogóle sięgnie się po kod.